电商 AI 运营助手
用 1 亿条淘宝用户行为数据,回答“用户在哪流失、谁是核心用户、哪些品类值得优化”,再用大模型把查数、写周报、答客服这三件重复的事自动化。
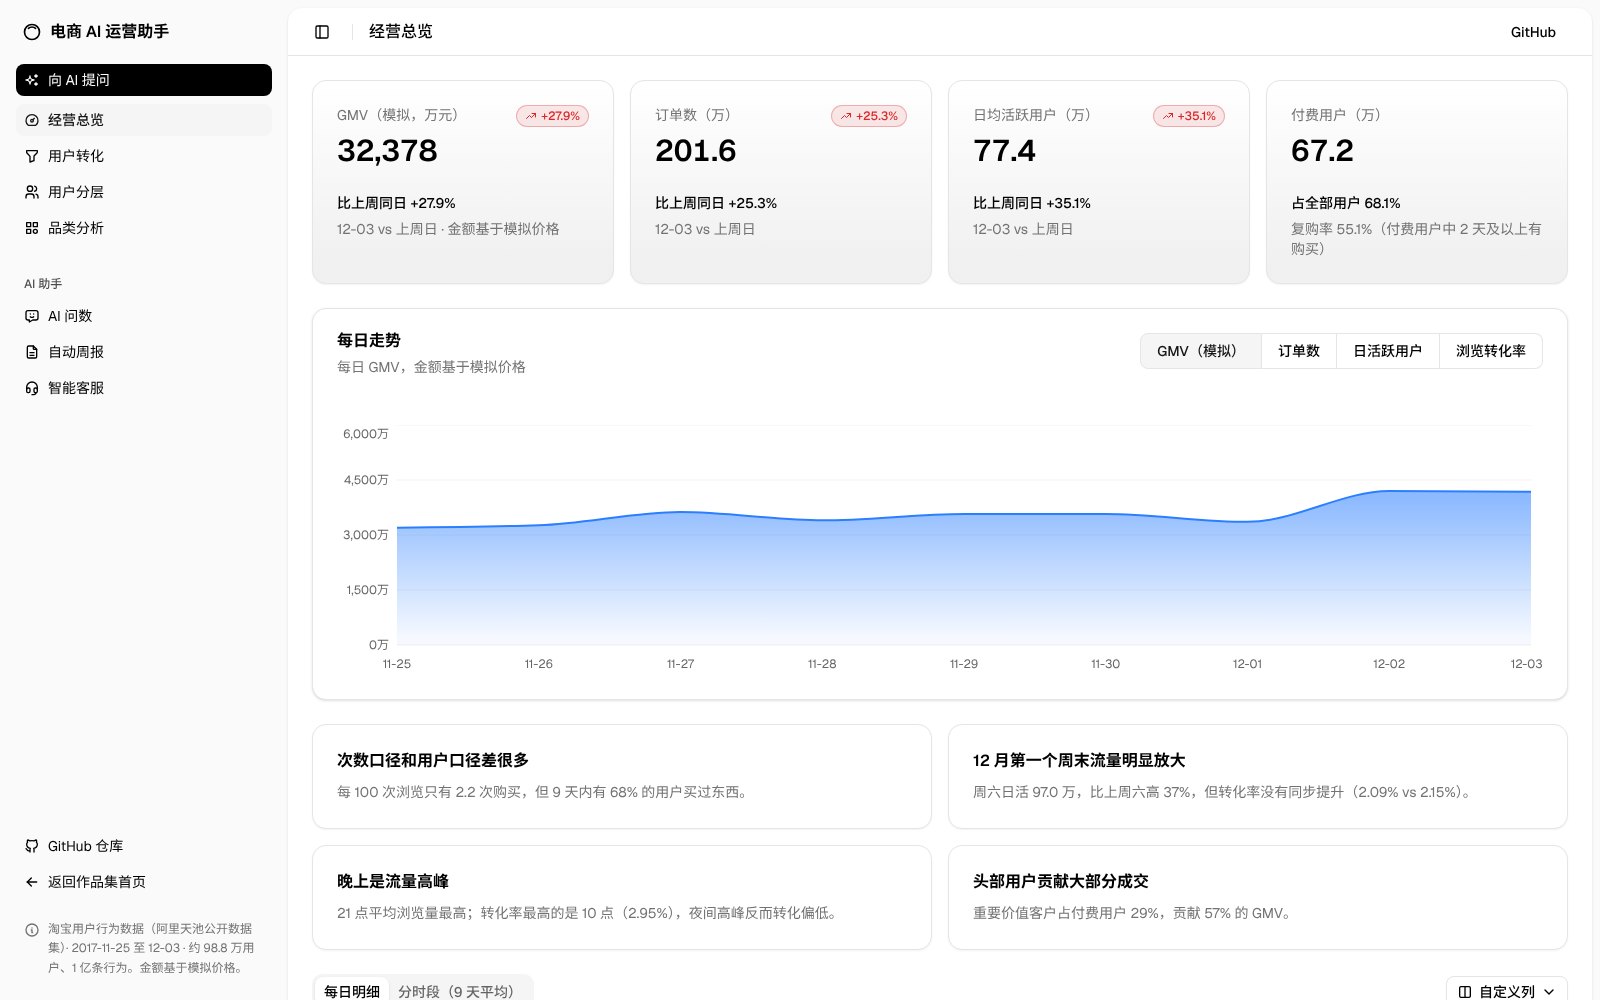
一个看板,三个 AI 助手
看板和 AI 功能都建立在同一套指标上,口径一致。AI 功能好不好,不靠挑几个问题演示,而是给每个功能准备带标准答案的测试题,用数字说明效果。
先把数据整理成可靠的指标
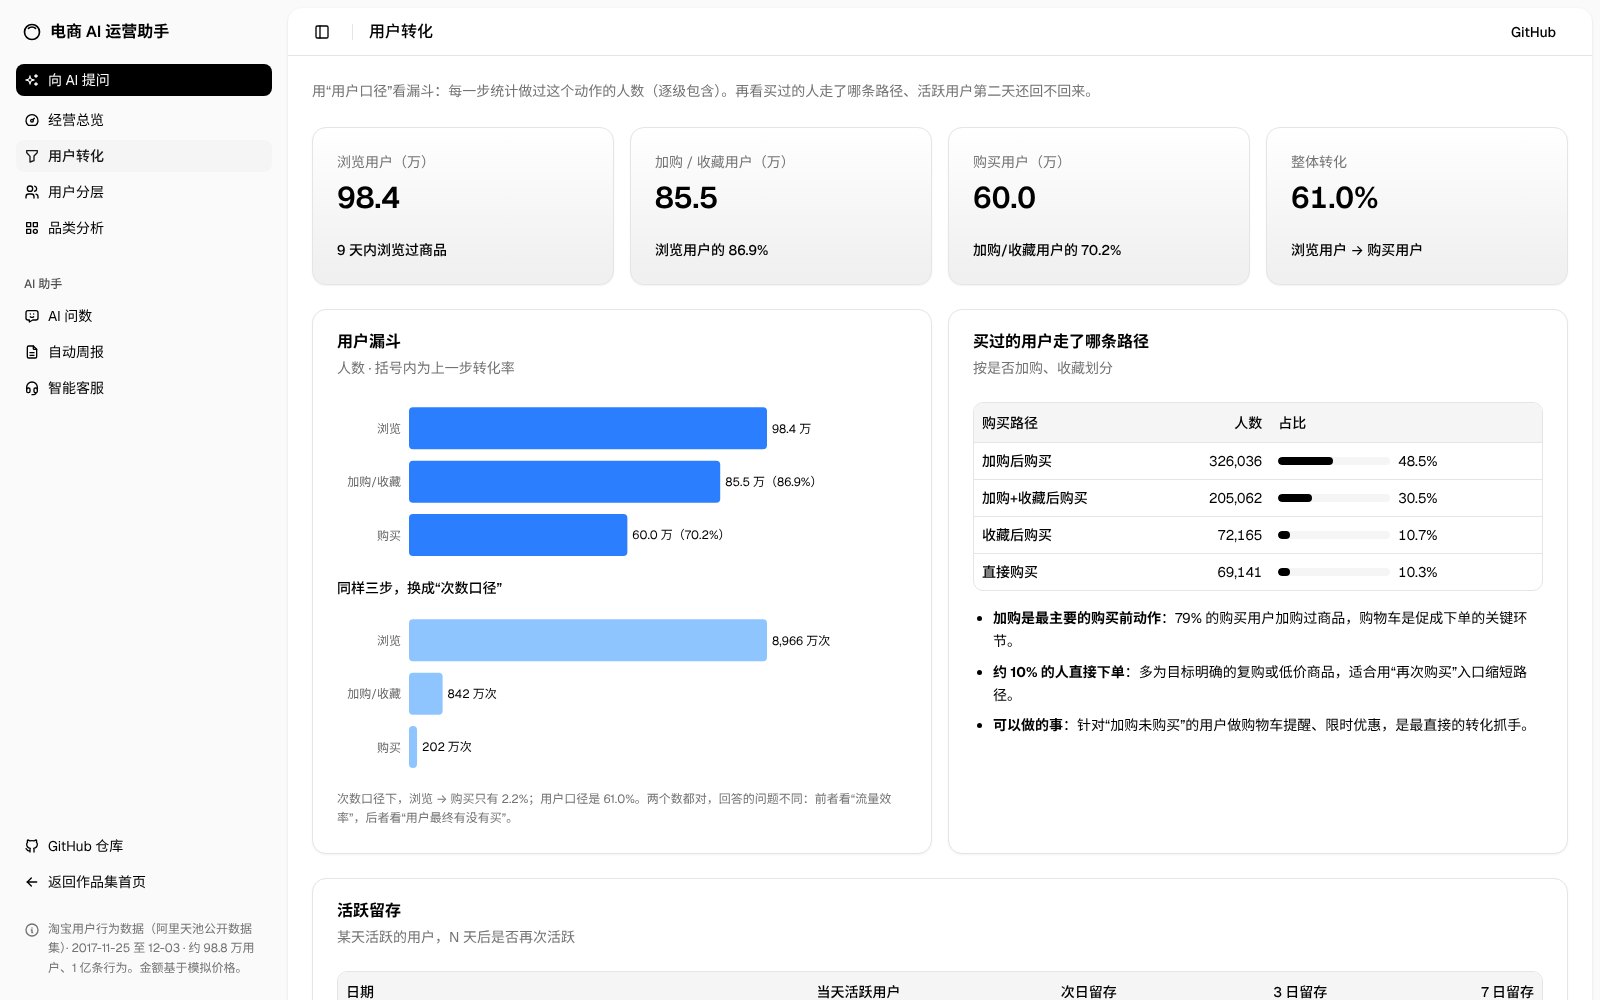
经营总览、用户漏斗、RFM 用户分层、品类四象限。每一页都是结论在上、细节在下,打开就知道该看哪里。界面套用 shadcn/ui 官方的 dashboard-01 模板,数据来自数仓的指标表。
金额基于模拟价格(原始数据没有价格),只用于演示分析方法
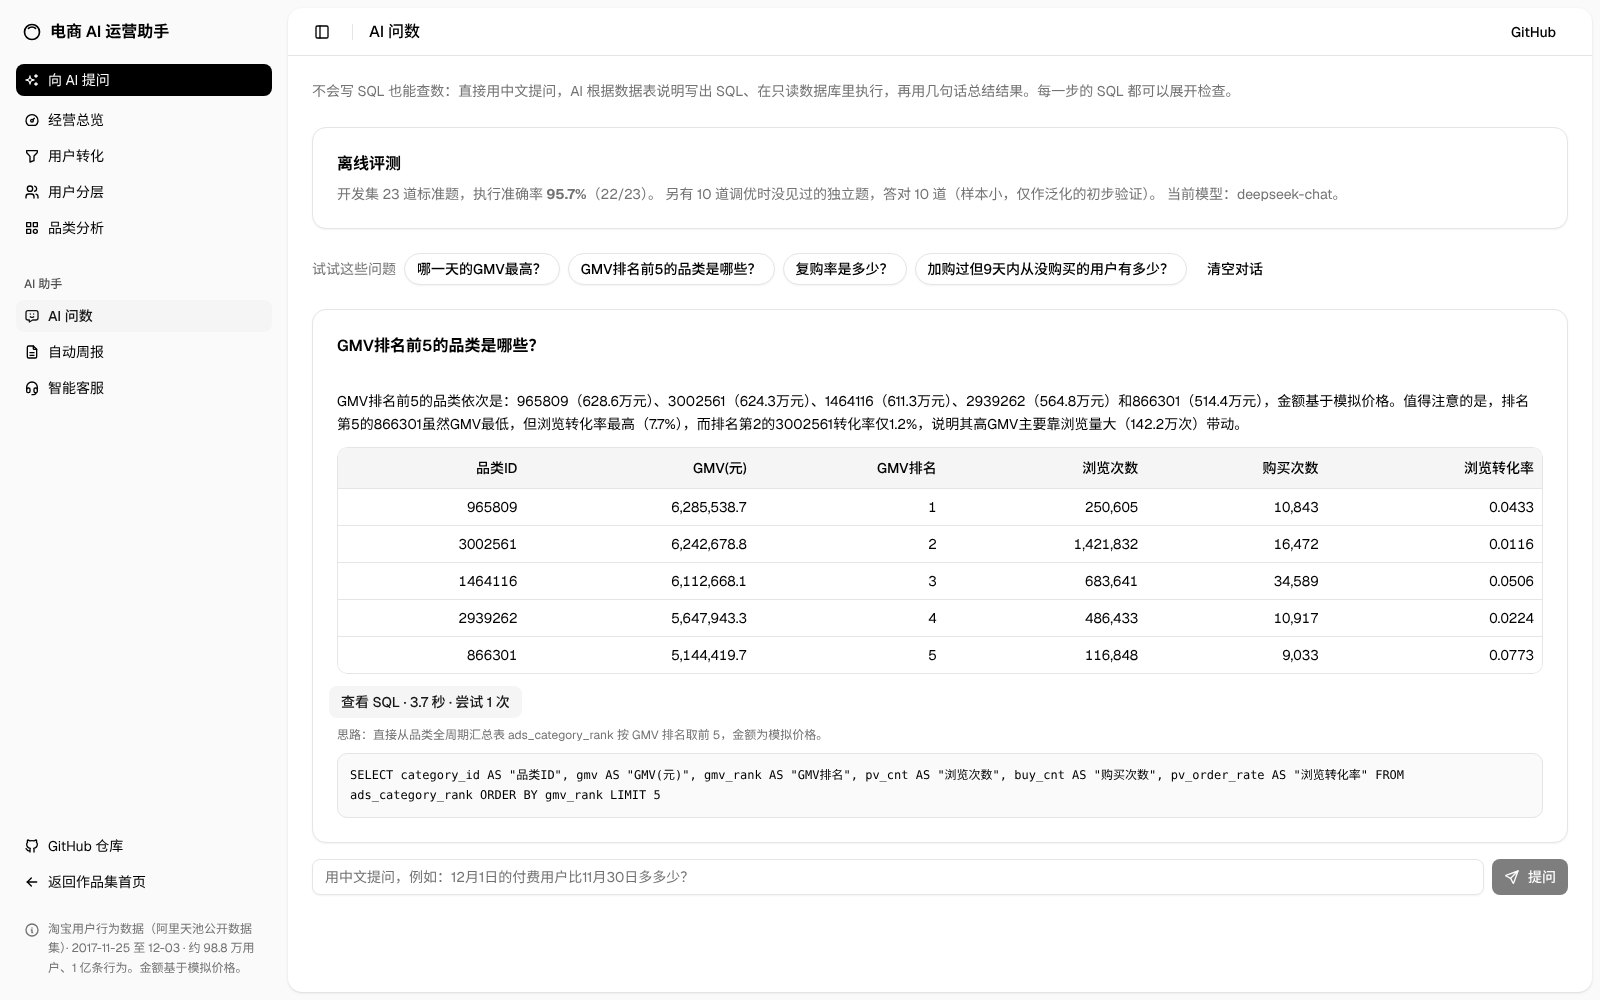
用中文提问,AI 写 SQL 查数据
AI 根据数据表说明写出 SQL,在只读数据库里执行,再用一句话总结。SQL 报错时,会把错误信息发回给 AI 自动修正。
防误操作:只读连接、只允许查询语句、30 秒超时
截图为系统真实输出的记录回放(deepseek-chat),在线版可自己提问
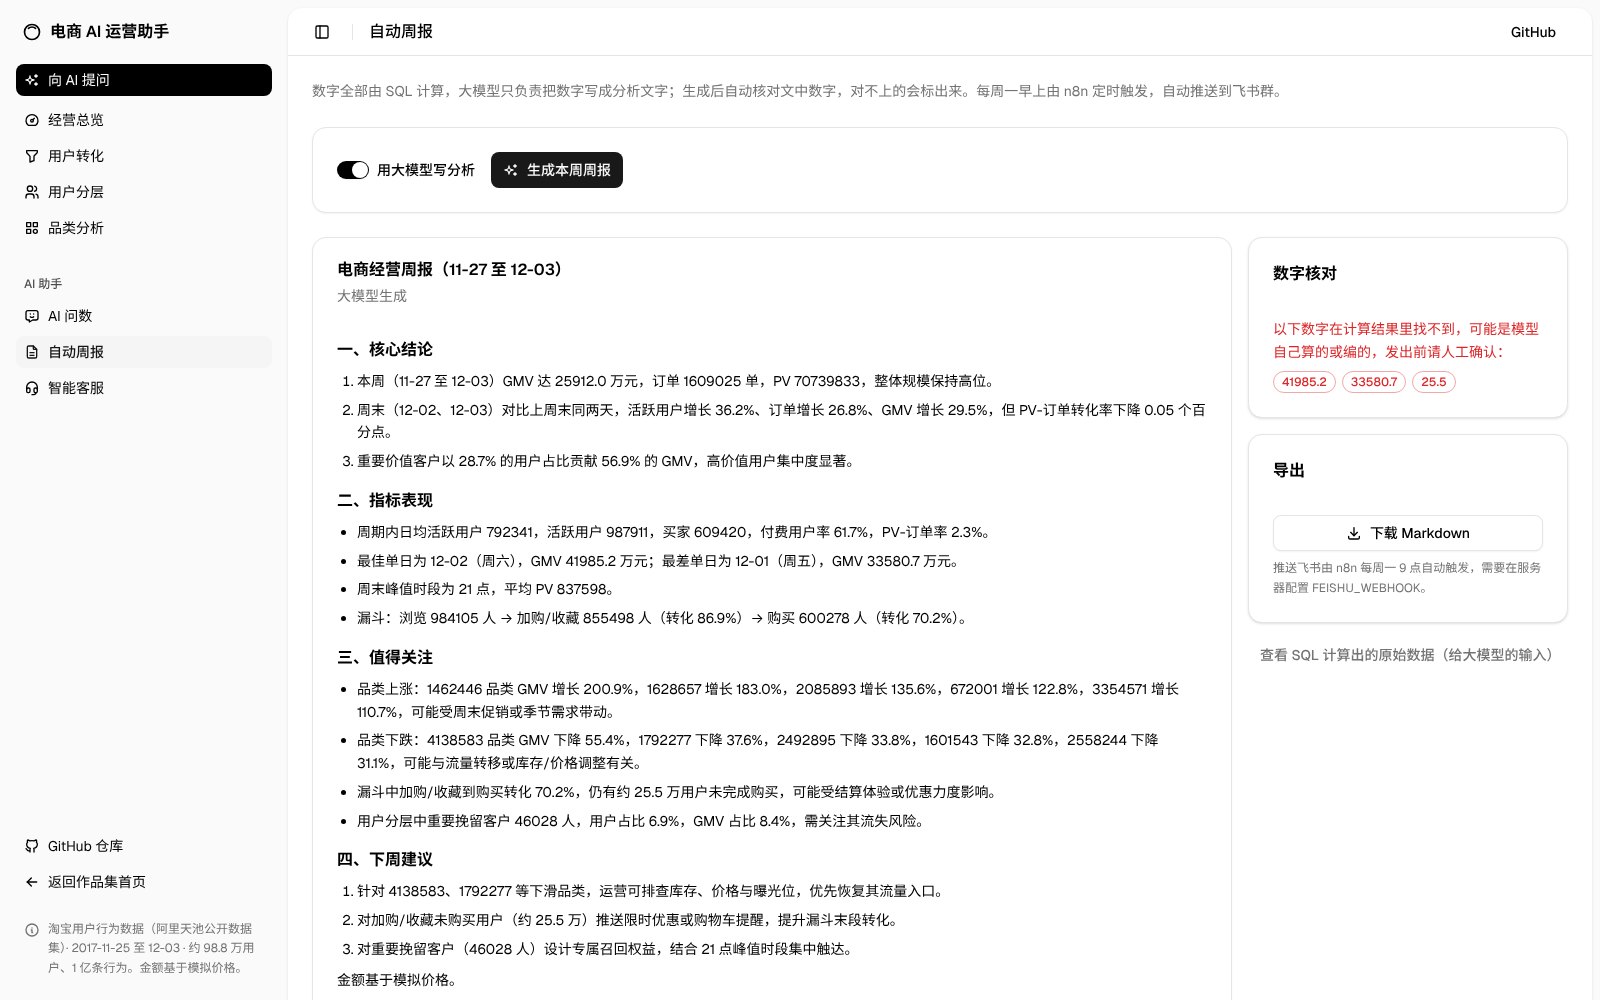
SQL 算数,AI 写分析
数字全部由 SQL 计算,AI 只负责把数字写成分析文字,写完自动核对文中每个数字。n8n 每周一 9 点触发,核对通过就推送到飞书群。
AI 调用失败时自动改用模板,保证周报照常发出
真实拦截案例:大模型把单日 GMV 4198.5 万元写成了 41985.2 万元(单位差 10 倍,比全周还大),核对程序当场标出;随机篡改 500 次,拦下 88.2%
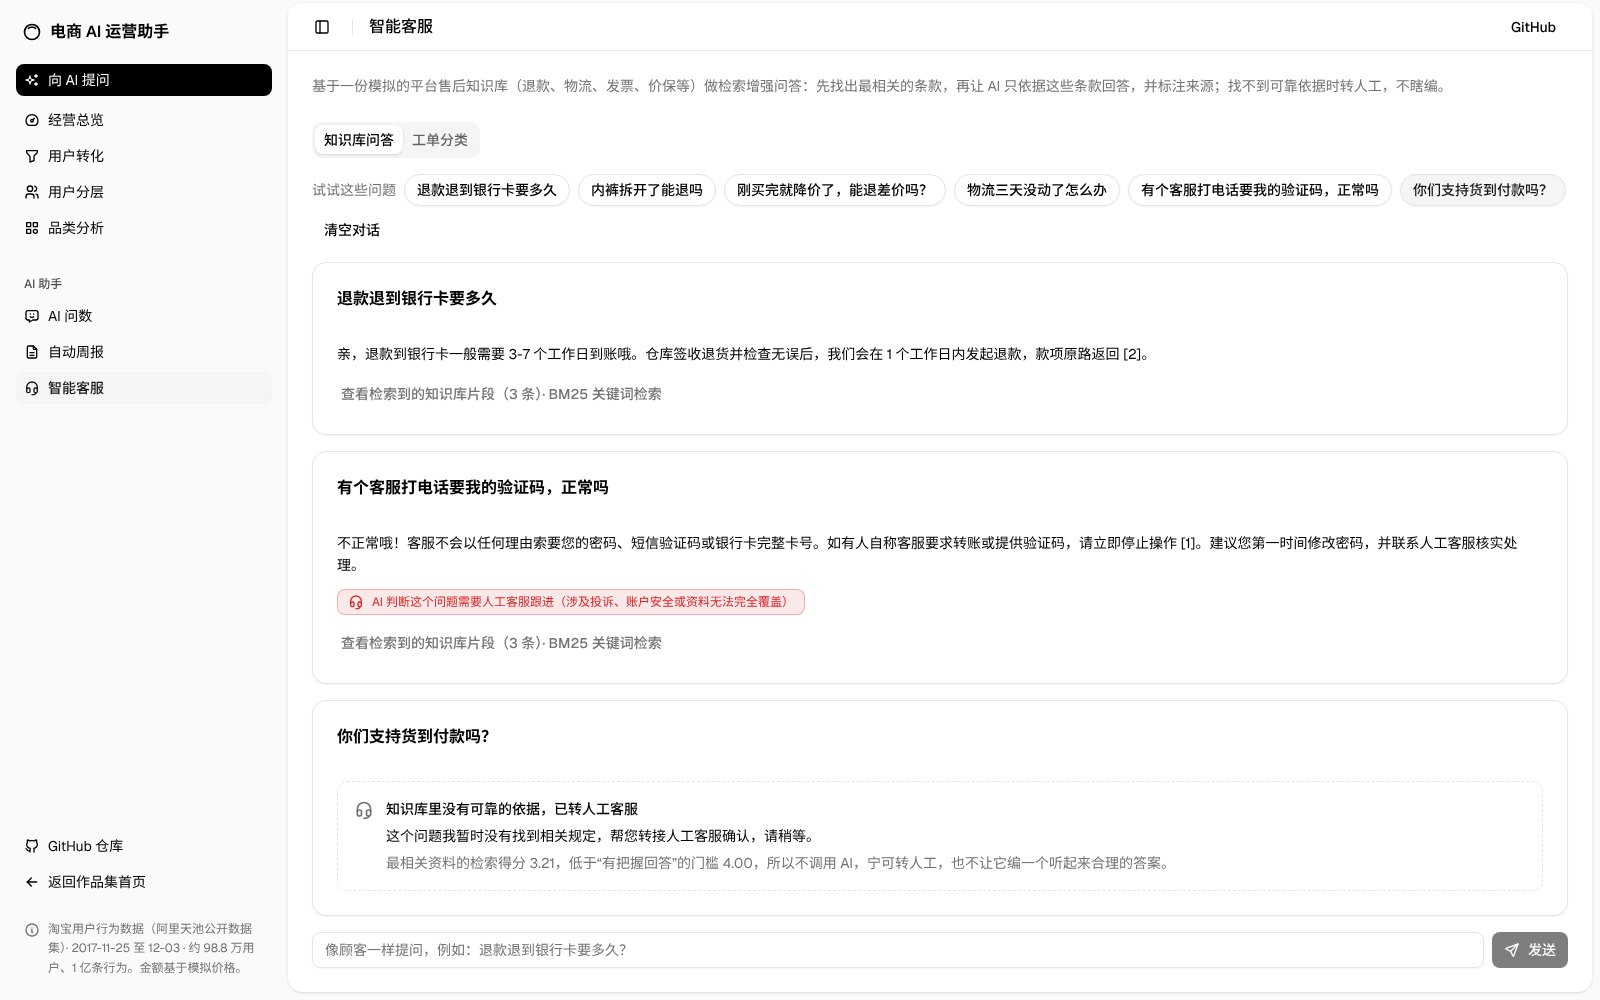
只根据店铺规则回答
先从店铺规则里检索相关条款,再让 AI 只根据这些条款回答,并标注出处。知识库里查不到的问题不调用 AI,直接转人工。
工单分类:大模型 60/60,关键词规则 56/60
截图为系统真实输出的记录回放(deepseek-chat),在线版可自己提问
怎么做的
数据先分四层整理成可靠的指标,看板和 AI 功能都从最上层的指标表取数。
从数据里发现了什么
金额类指标基于模拟价格(原始数据没有价格),只用于演示分析方法。
79% 买过东西的人都先加过购物车
购物车是下单前最关键的一步。“加购了但没买”的用户,是最直接、成本最低的转化对象,适合做降价提醒和限时券。
不到 3 成的用户贡献了 57% 的成交额
用 RFM 模型把付费用户分成 8 类,“重要价值客户”占 28.7%,贡献 56.9% 的 GMV。运营资源应该优先投给他们,防止流失。
周末流量涨了 36%,转化率却没涨
12 月第一个周末日活比上周末高 36%,但浏览转化率从 2.15% 降到 2.09%。增长来自“来的人多了”,不是“买的比例高了”,活动复盘要同时看效率。
一个好得不正常的数字:留存率 98%
只要统计日落在 12 月 2 日或 3 日,留存率就跳到 98%。我判断这是数据集抽样方式造成的,没有直接采用,只用正常区间的 78%–80%。先怀疑数据,再下结论。
5.6% 的品类贡献了 80% 的成交
用“流量 × 转化率”四象限找出流量大、转化差的品类。粗略估算,把这批品类的转化率提到中位数,能多出约 39 万笔订单。
还不够好的地方
写清楚局限,比只展示好的一面更有说服力。
- 数据只有 9 天,看不到月度趋势和长期留存,RFM 只能用简化的高/低两档。
- 客服测试题、工单和关键词规则都是我自己写的,100% 的结果偏乐观,真实工单会难得多。
- AI 问数 23 道标准题里唯一的错题,是看完错题后补了一条说明才修好的。为此另出了 10 道新题,提示词没有为它们改动,结果 10/10;但只有 10 题,样本小,只能说明没有明显的“对着考题改”,下一步会出更难的第二批。
- 周报的数字核对只检查“数字在不在数据里”:假数字恰好等于数据里另一个数时拦不住,所以拦截率不是 100%,它的作用是标出可疑数字交给人确认。
- 评测只检查关键词,发现不了推理上的小错误,比如 AI 把“半年前”直接当成“超过 180 天”。
用到的技术
- SQL
- DuckDB
- Parquet
- Python
- pandas
- React
- shadcn/ui
- Recharts
- DeepSeek API
- Text-to-SQL
- RAG
- BM25
- FastAPI
- n8n
- Dify
- 飞书机器人
- Git